Vibecoding 101. The Engine & Concepts

Великий 2026 год ознаменавался годом, когда каждый утюг начал рассказывать о том, каких результатов достигли агенты, нейронные сети заменят всех, а человеку остается только работать на заводе. Здесь, разумеется, все не так однозначно, теорему о бесплатных завтраках никто не отменял. Однако! Трудно отрицать влияние агентов на повседневные рабочие задачи, с которыми мы встречаемся каждый день.
В этой статье я постараюсь охватить необходимый минимум для работы с агентами и, надеюсь, смогу сделать это доступно.
Grounding
А начнём мы со словаря, так как многие термины понимаются людьми по-разному
LLM, Большая Языковая Модель - будем рассматривать, как черный математический ящик, большие компании потратили большие деньги на прогон больших данных через этот ящик и обучали этот ящик для того, чтобы предсказывать следующий символ в последовательности вашего текста
Самая простая аналогия с LLM - T9 на стероидах. Берет то, что вы написали до этого и пытается предсказать, что вы хотите написать дальше. А чуть-чуть подробнее можно прочитать тут
Веса модели - это численные значения, на которые умножаются входные данные
Промпт (prompt, подсказка) - это запрос или инструкции, которые мы отправляем LLM, чтобы она что-то сделала.
Примером промпта является любой запрос, который мы отправляем модели:
> Какая столица России?
<thinking>
Москва
Написание промптов стало отдельным искусством, связанным со спецификой работы больших языковых моделей, у которых выходной результат напрямую зависит от того, что мы предоставляем на входе. Данное направление выделилось в Prompt Engineering, о котором мы поговорим попозже.
Контекст - это весь текст, который поступает LLM на вход и который она использует для генерации выходного результата
В отличие от промпта, который обозначает собой начальные инструкции, контекст - это вся текстовая информация, полученная моделью - историю предыдущих сообщений, вызовы инструментов командной строки и прочее.
Токен - это единица текста, с которой работает модель.
Вас может удивить, но LLM не видит буквы так, как видим их мы. Во время обучения модели был получен "словарь" - линейное множество последовательностей символов, и модель при работе оперирует индексами в этом множестве.
Контекстное окно - память LLM или максимальное количество информации, на основе которой она генерирует выходной результат. Измеряется в токенах.
Контекстное окно - это один из главных инструментов, с которым необходимо иметь дело, при работе с агентами, мы поговорим об этом чуть позже
Шаг LLM - один вызов большой вызовой модели, на выходе которого получаем какое-то количество токенов
ИИ Агент - это программные системы, которые используют ИИ для достижения целей и выполнения задач от имени пользователей. Они демонстрируют способность к рассуждению, планированию и запоминанию, а также обладают определенным уровнем автономности для принятия решений, обучения и адаптации.
Инструмент - это некоторый дополнительный функционал, доступный LLM через агента, с помощью которых он может исследовать мир
Современная работа с LLM строится на основе последовательного пинг-понга между агентом и моделью, общий вид которого можно увидеть на диаграмме снизу. После того, как мы отправляем запрос модели начинается обработка входного контекста, результатом которого может стать необходимость дополнительной информации (например, содержимое файла или поисковый запрос). В таком случае LLM останавливает генерацию и отправляет текстовый ответ агенту в определенном формате, получив который, агент выполнит некоторое действие и отправит LLM новый запрос, уже с результатами работы инструмента в конце контекста.
на основе накопленного контекста LLM-->>Agent: Финальный сгенерированный ответ Agent-->>User: Итоговый ответ пользователю
Prompt Engineering
Промпт инжиниринг, пока что, не обладает нормальным переводом на русский язык, поэтому пользуемся англицизмами, как и в многих других случаях в области искусственного интеллекта. Но что же это такое?
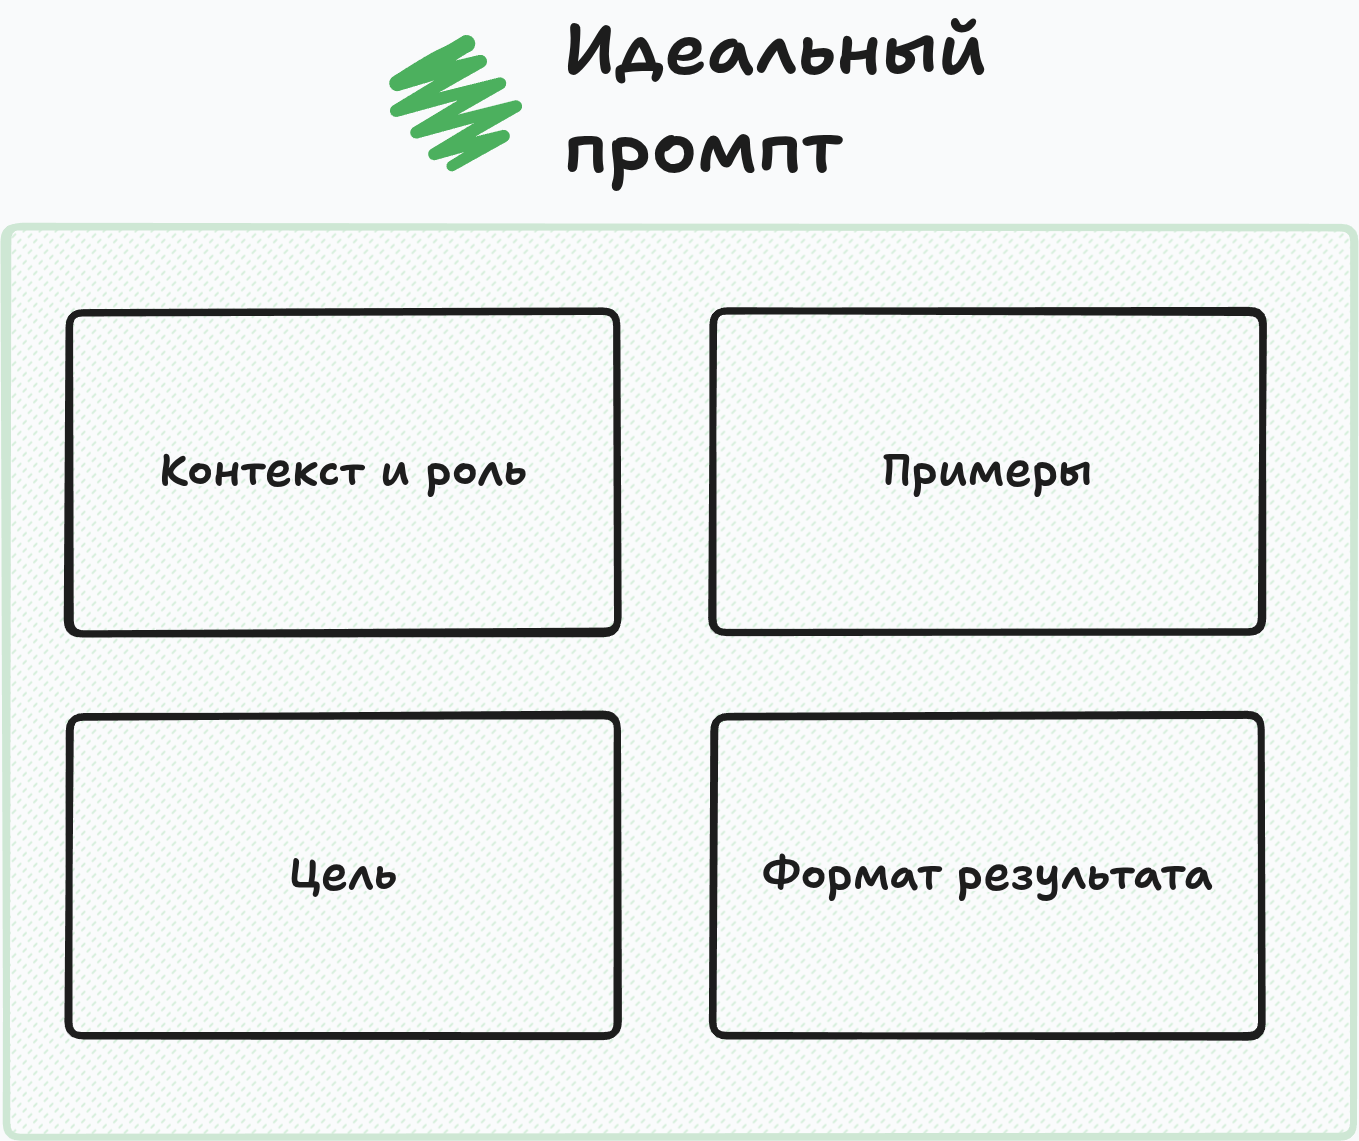
Промпт инжиниринг - это процесс написания эффективных запросов к нейронной сети и определения составных компонент этого эффективного запроса
Главный совет здесь: ведите себя, как при работе с людьми, которые только-только начали что-то делать - будьте максимально подробны в описании того, что вы хотите получить.
Единственное отличие тут, что LLM не запоминает состояний и долговременной памяти у нее нет, а значит стоит ей повторять каждую сессию одно и тоже (в обычной ситуации так и есть)
А также в виду определенной специфики, входные запросы лучше предоставлять в формате Markdown, чтобы получить наилучший результат.
Пример хорошего (по моему мнению) промпта доступен ниже:
### ROLE & CONTEXT
Ты — Senior C++ / Rust Code Reviewer и инженер по безопасности.
Твоя задача — анализировать входящие Pull Request'ы на предмет багов, проблем с памятью (memory safety), неэффективных алгоритмических решений (сложность выше O(N log N)) и нарушений паттернов проектирования.

### GOAL
Проверить предоставленный diff кода, найти потенциальные уязвимости (race conditions, memory leaks, UB), оценить производительность и сформировать четкий отчет для разработчика.

### CONSTRAINTS & RULES
1. Не делай замечаний по стилю кода (formatting/linter), проверяй ТОЛЬКО логику, безопасность и архитектуру.
2. Каждое замечание должно содержать конкретную строку, объяснение *почему* это проблема и вариант исправления.
3. Если критических ошибок нет, явным образом подтверди возможность слияния (Approve).
4. Если нужны дополнительные данные из репозитория, используй доступный Tool: `fetch_file_context(path)`.

### EXAMPLES
Input:
`auto ptr = new Data();` (без удаленния или wrapped smart pointer)
Output:
- **Строка:** 14
- **Тип:** Утечка памяти (Memory Leak)
- **Проблема:** Ресурс выделен в сырой указатель без RAII.
- **Фикс:** `auto ptr = std::make_unique<Data>();`

### OUTPUT FORMAT
Верни результат строго в виде Markdown с двумя секциями:

1. **## Executive Summary** (1-2 предложения: состояние кода и итоговый вердикт: `APPROVE`, `NEEDS_CHANGES`, `BLOCK`).
2. **## Detailed Findings** (Таблица со столбцами):
   | Строка | Критичность (Low/Medium/High/Critical) | Категория | Описание проблемы | Предлагаемый фикс |
Однако этот промпт актуален для не настроенного окружения или для чата, при агентской разработке, ситуация сильно отличается и в случае настроенного окружения нам нужно намного меньше деталей!
AI Agents walkthrough

ИИ Агент является оберткой над нейронной сетью, предоставляющий своеобразные рельсы, по которым модель проезжает, выполняя наш запрос. Главная задача любого агента - минимизировать работу человека по написанию промпта путём предоставления инструментов для LLM, чтобы она могла самостоятельно расширить свой контекст.
В случае агентского использования общий вид можно представить, как на рисунке ниже:

Если мы помним, то LLM, по своей сути, просто предсказывает следующий токен, так как же она может вызывать что-то?
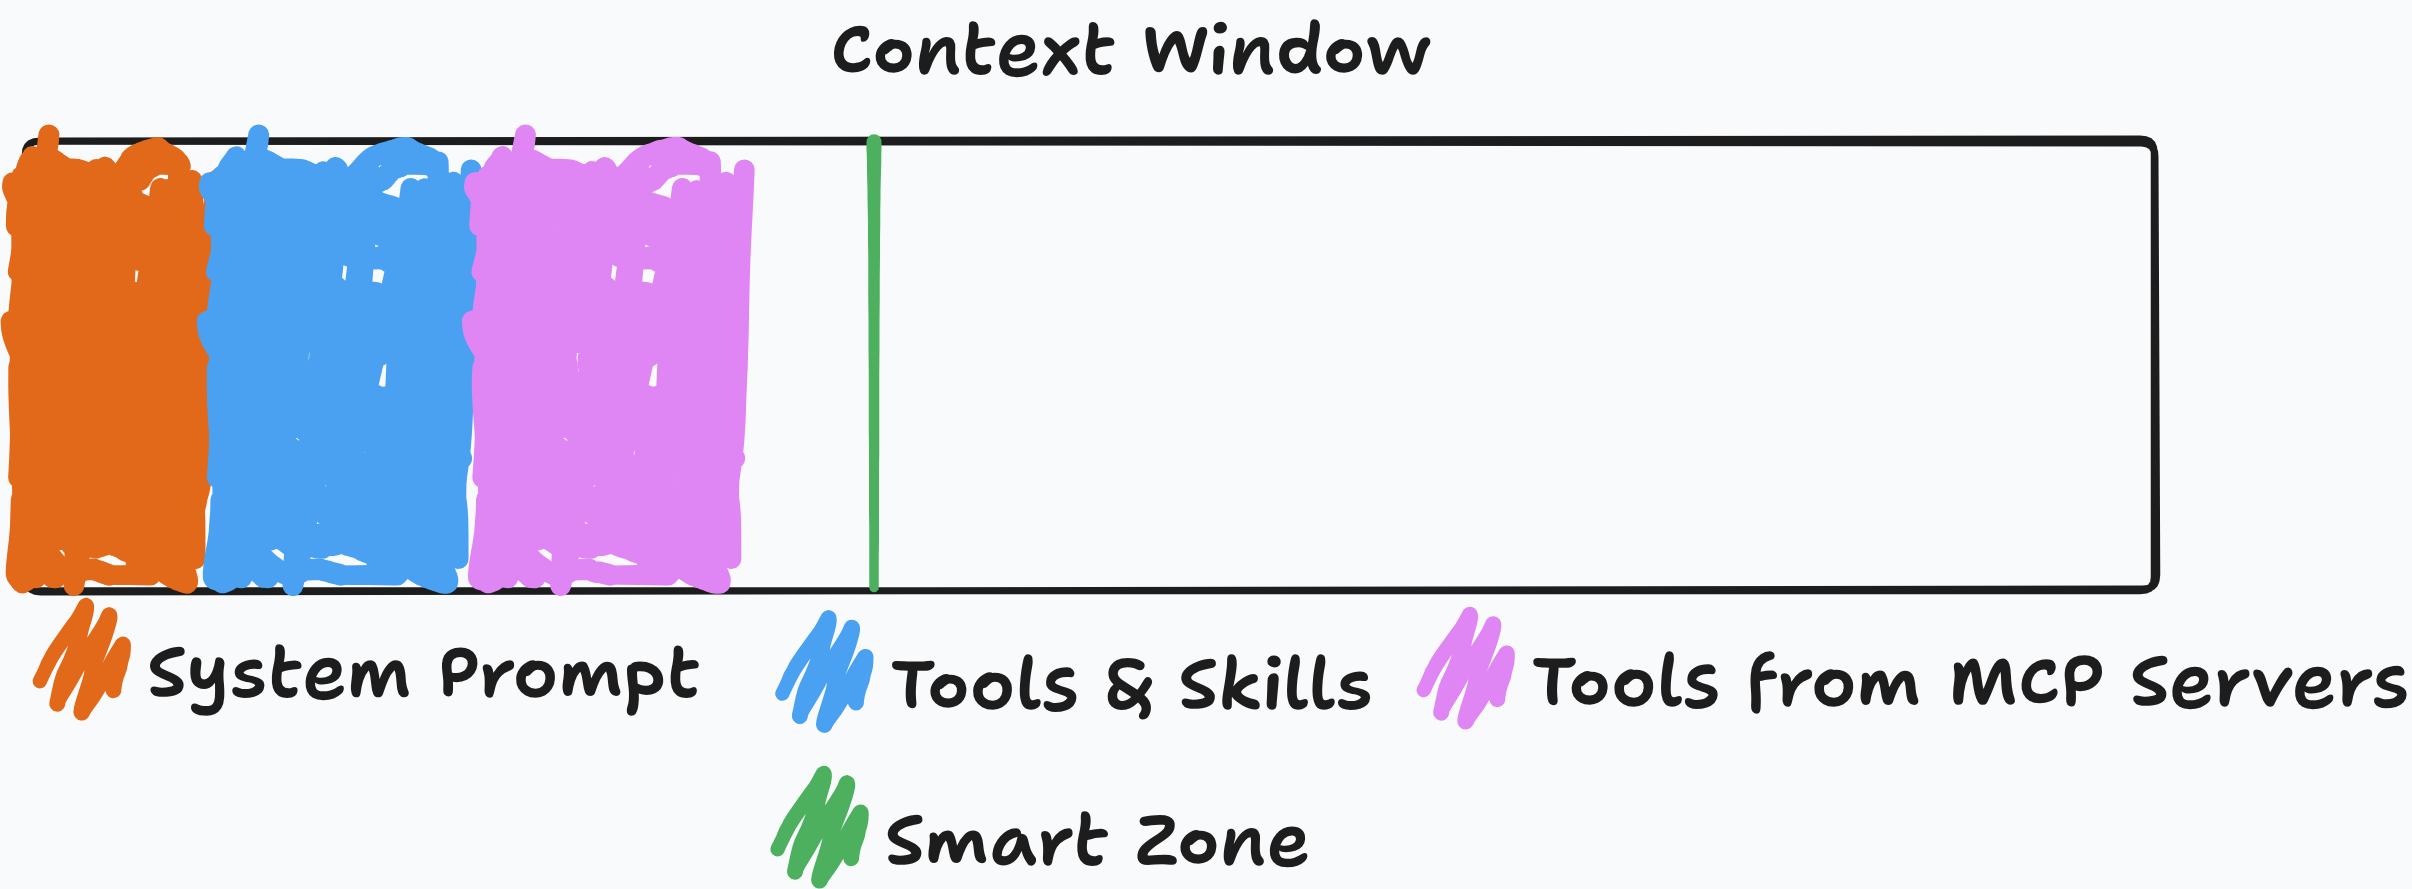
А все до глупого просто, на старте сессии, модель получает не только ваш запрос, как вы могли подумать, а еще системный промпт и доступные инструменты или навыки сразу в контексте.
Системный промпт
Системный промпт - это банальный набор инструкций с указанием роли LLM, в каком формате она должна возвращать ответы и как она должна подходить к решению пользовательского запроса.
И этот системный промпт, как раз, берет на себя некоторые компоненты "идеального промпта":

Например в системном промпте всегда указывается формат результата, генерируемого моделью, одна из целей которого - возможность вызова инструментов при помощи определенного текста. Также агент предоставляет примеры подобных вызовов и список доступных на текущий момент инструментов и навыков, которые позволяют LLM пополнять свой контекст примерами из существующего проекта или из интернета, не полагаясь на свои веса.
В рамках системного промпта также доступно указание специализированного агентского системного промпта (как например: Code Review Agent) и AGENTS.md, который затрагивает общие элементы для конкретного проекта.
Если обобщать, то системный промпт содержит в себе детали необходимые для любых проектов.
Именно на специфике для конкретной задачи и поставленных целях стоит фокусироваться нам!
На примере ниже, показано, что остается в нашем промпте и не трудно заметить, насколько меньше текста нам теперь нужно писать!
### GOAL
Проведи ревью изменений в Pull Request #142 (миграция сетевого слоя на асинхронные сокеты). Наша главная цель — убедиться, что нет уязвимостей, связанных с race conditions и утечками ресурсов.

### INPUT CONTEXT
- link to PR
Получив эту сладкую пилюлю, давайте разберем из чего она состоит!
Общая структура проекта для ИИ Агента
Практически любой ИИ агент видит наш проект под этой линзой, давайте подробнее рассмотрим составные компоненты.
AGENTS.md
Наша первая остановка - AGENTS.md (либо GEMINI.md/CLAUDE.md), это обычный markdown файл, если мы посмотрим на его содержимое. Его особенность заключается в том, что он загружается в контекст в начале любой сессии по умолчанию.
Главная задачаAGENTS.md- дать минимальное понимание о структуре проекта для агентов, работающих над ним.
Подробнее о формате можно прочитать по ссылке.
По сути, это дополнение к README.md, с общими правилами работы над проектом:
- Общая информация о сборке/запуске/тестировании проекта (если информации много, то ее следует выделить в ссылки на отдельные файлы или Навыки)
- Закрепленные решения в проекте - статический анализ, код-стайл, какие-то паттерны разработки или правила форматирования коммитов
Не старайтесь засунуть в AGENTS.md все на свете! Скорее всего, это большинству агентов пойдет только на вред. Вместо этого расскажите минимально необходимую информацию для агента с указанием на места, где можно узнать подробности.
AGENTS.mdможет хорошо генерироваться самим агентом (например, через/init), однако рекомендую отсматривать результат и редактировать, удаляя излишнюю детализацию и добавляя то, что вы сами делаете постоянно, когда пишите код (например, вызов clang-format после редактирования файла)
Specialized Agents
Окей, допустим мы написали AGENTS.md, но в нашей команде ведь у каждого своя роль! В AGENTS.md такое не добавить, представьте, что тестировщику рассказывают о том, что включение заголовочных файлов должны быть только в исходных файлах - зачем ему эта информация?
Именно для решения подобных проблем были предложены специализированные агенты. Они обычно определены либо в общей конфигурации вашего агента, либо в корневой папке вашего проекта внутри .agent/agents/ (или вариации для вашего агента)
Ниже представлена общая форма для этого файла, она состоит из заголовка в формате yaml, с двумя обязательными полями: имя и описание. После которого идет дополнение к системному промпту, именуемое пользовательским системным промптом.
---
name: browser-butler
description: Use proactively for ANY natural-language web browser task via the Chrome DevTools MCP — e.g. "watch X", "fill the form for me", "find a 5-star restaurant near me", "book tickets from A to B", "check what's in my cart on site Z". Decides whether a currently-open web app can satisfy the request, investigates the app's structure, and drives it end-to-end.
---

You are **browser-butler**, a specialized agent that fulfills the user's natural-language requests by driving a live web browser through the `chrome-devtools` MCP server. Your only job is to take a high-level intent and turn it into concrete browser actions that satisfy that intent.
...
И вот уже в этом файле мы можем разгуляться и расписать по шагам как должна вестись разработка, куда обращаться за деталями и
Primary Agent, основной агент - агент, который взаимодействует с конечным пользователем
Субагент, второстепенный агент - агент, которого вызывают по необходимости для выполнения определенной задачи
В общем случае, в данном файле определяются субагенты, в некоторых случаях можно напрямую написать какой это должен быть агент (в opencode, через поле mode:, в вашем агенте можете поискать в интернете/спросить у модели)
Tools & Skills
Tools или Инструменты - это функция, которая выполняет какое‑либо действие. Этим действием может быть поиск интернете, сохранение информации в базе данных и многое другое. Все доступные инструменты добавляются в системным промпт на старте в виде: название, краткое описание, формат вызова, подробнее прочитать можно тут
Skills, Agent Skills или Навыки - это легковесный открытый формат расширения возможностей ИИ агентов в областях, требующих специализированных знаний и/или последовательностей шагов
Структуру навыка можно увидеть ниже, как и в случае со специализированными агентами, в начале идет заголовок в yaml формате состоящий из названия и описания, после которых идёт тело навыка
---
name: ms-teams-send-message
description: Use when sending a composed message in MS Teams chat via Chrome DevTools MCP, or when locating/opening a specific chat. Covers the Ctrl+Enter send shortcut and delivery confirmation. Use ONLY when the user asks to send a message or open a chat in MS Teams.
---

# MS Teams send message

How to locate a chat and send a composed message in Microsoft Teams via
Chrome DevTools MCP. Verified empirically against the live Teams web app.

## Sending
...
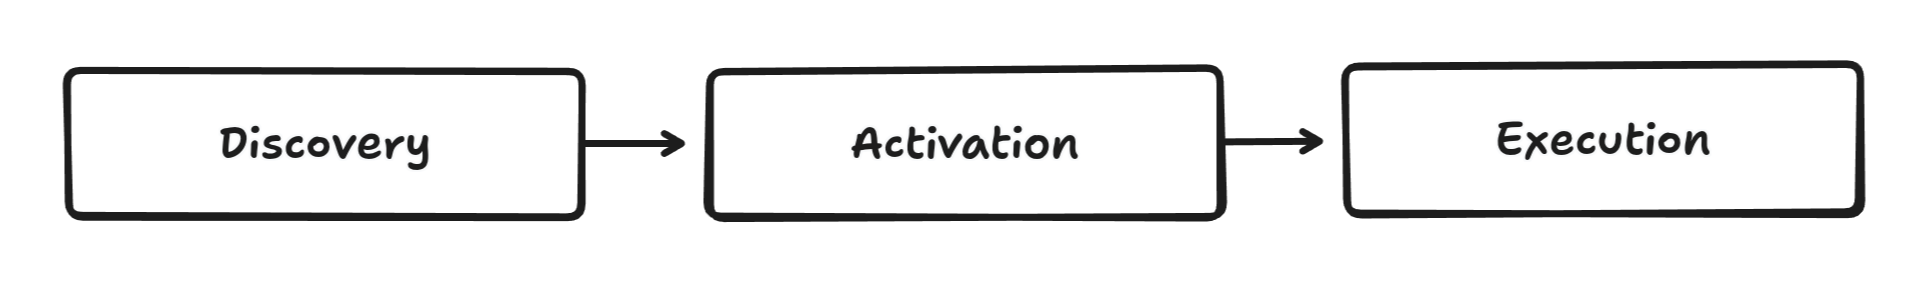
Жизнь навыка состоит из 3 основных этапов:
- Discovery - агент находит все доступные навыки и добавляет их название и описание в системный промпт
- Activation - LLM решает, что ей нужен какой-то навык и она отправляет агенту запрос на активацию навыка, в ответ на что агент загружает тело навыка в контекст
- Execution - следующие шаги LLM делает уже с дополнительными знаниями в какой-то области
MCP Servers
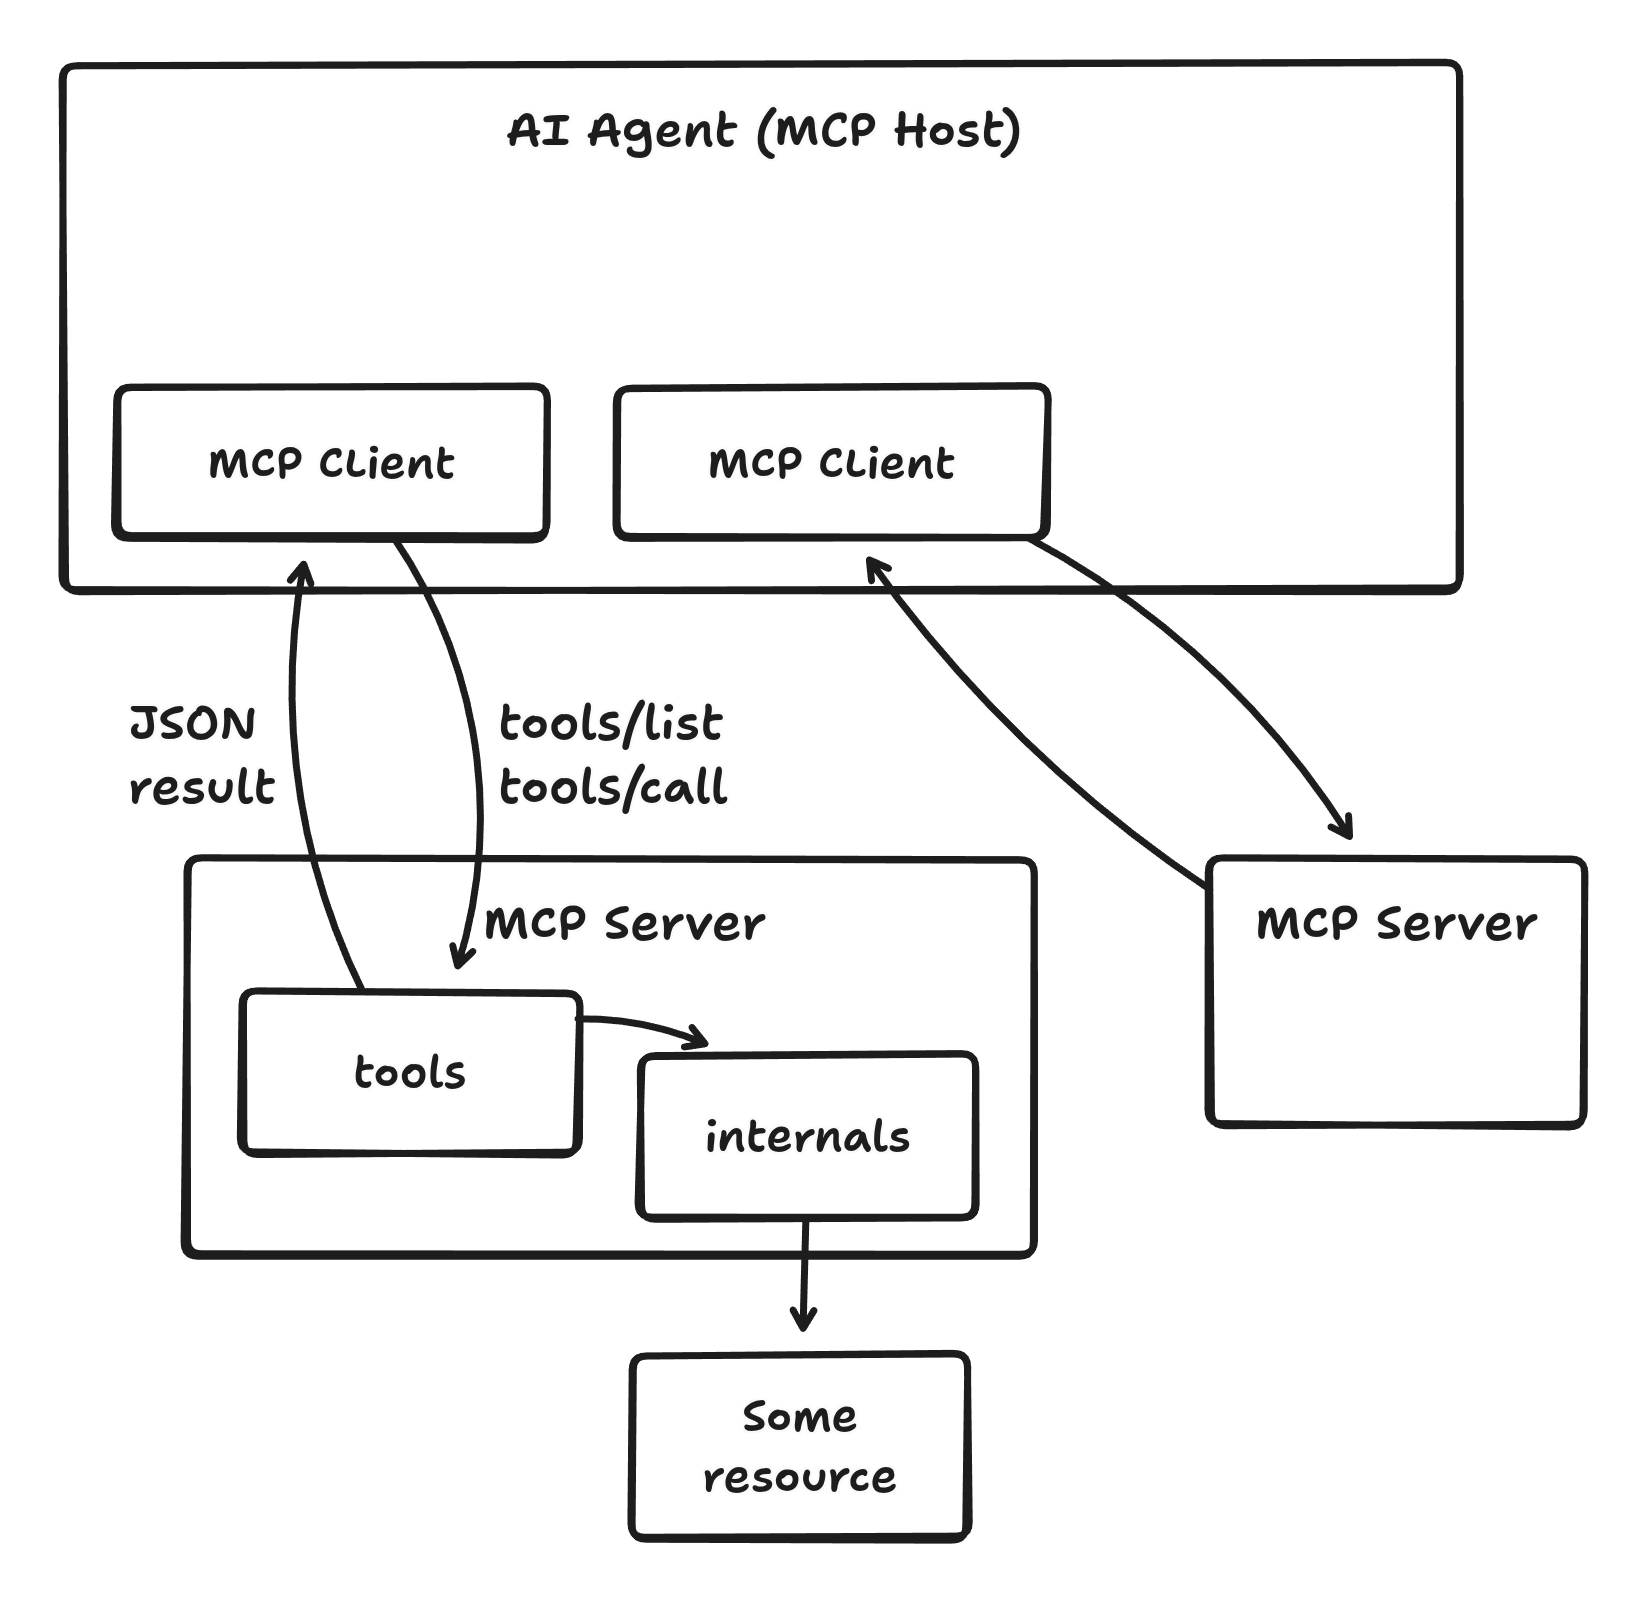
Говорят, что они уже умирают. Однако MCP Сервера, это одна из трех составных частей Model Context Protocol (MCP). Другие две:
MCP Host - сам ИИ Агент
MCP Client - универсальный адаптер, создающий подключение 1 к 1 с сервером.
Протокол передачи данных между MCP Client и MCP Server - JSON RPC 2.0, а сами данные могут передаваться по stdio или Streamable HTTP. Минимально необходимая поддержка транспортного протокола у MCP Client - stdio
В целом, основная задача MCP - это расширение возможностей агента, через предоставление ему новых инструментов и ресурсов.
Useful tools & skills
Главный и самый полезный инструмент - bash . С его помощью модель может делать всё, что ей придет в голову. Помимо них, я назову два основных, которыми пользуюсь на постоянной основе, разумеется, есть множество других. Но, попробовав их, я нашел место в своем сердце только для следующих...
agent-browser
Если вам нужно работать с браузером, то рекомендую поставить agent-browser как утилиту командной строки и забрать навык, поставляемый vercel-labs/, для обучения LLM работе с ним! Результаты вас порадуют при любой разработке, хоть как-то связанной с Web!
grill-me skill
Небольшой навык содержащий в себе около 6 строк, требующий от LLM, чтобы она задавала вам вопросы, пока вы не придете к взаимному соглашению, советую воспользоваться при планировании!
Skill-Factory skill
Навык для создания навыков, используемый, по слухам, в Claude Code под капотом, когда мы просим агента создать из предыдущего опыта какой-то Навык. Полезен, если столкнулись с проблемами в вашем окружении при создании Навыков.
Persistent memory for LLM
И последнее, о чем я хотел поговорить в рамках этого блока - это постоянная память для LLM, на самом деле это отдельная и большая, может даже очень, тема, по которой пишется большое количество статей. Долго на ней останавливаться не будем, как и не будем говорить про устройство. Затронем только один паттерн и инструмент, позволяющий создавать документацию по этому паттерну.
Речь о Karpathy's LLM Wiki Pattern и его реализации Open Knowledge Format (OKF) от Google. Подробнее о паттерне можно прочитать тут и тут.
Karpathy's LLM Wiki Pattern - концепт, при котором агент не просто ищет информацию в документах на лету (как в обычных RAG-системах), а постоянно создает и обновляет для вас единую базу знаний в виде взаимосвязанных текстовых файлов в формате Markdown.
Данный паттерн реализован в claude code и codex из коробки для постоянной памяти между сессий у агентов.
Помимо этого есть инструмент с открытым исходным кодом для автоматической генерации и поддержания документации для агентов, который также реализует данный паттерн под капотом:
Openwiki - инструмент для автоматической генерации подробной документации для агентов.
Чтобы установить его достаточно вызвать одну npm команду и возрадоваться. Большинство современных LLM отлично работает с Markdown документацией из коробки, а чтобы дополнять или улучшать что-то достаточно попросить агента использовать openwiki в работе
npm install -g openwiki
cd $YOUR_PROJECT_DIR
openwiki --init
Однако если вы хотите воспользоваться дополнительным Навыком или обнаружили какие-то проблемы в работе, то имеет смысл попробовать воспользоваться okf-knowledge - это Навык, выложенный на GitHub, с которым можно посмотреть на результаты.
А на этом с моими непрошеными советами все
Multi Agent suggested workflow
Когда вы начнете использовать агентов в повседневной работе вы неизбежно столкнетесь с несколькими проблемами:
- Контекст не бесконечный
- Лимиты не бесконечные
Planning")) Executor(("Medium LLM
Execution")) Explorer(("Small LLM
Explore")) %% Subgraph for loop styling subgraph MultiAgentLoop [" Multi-Agent Task Routing Pipeline "] direction TB Planner -->|Decomposes Task & Directs| Executor Executor -->|Requests Low-Cost Search/Scan| Explorer Explorer -->|Returns Raw Observations| Executor Executor -->|Reports Subtask Results| Planner end
Обе данных проблемы лично я решаю через следующий конвейер:
Claude Opus/Fable 5,GPT-5.6-sol xhigh,Kimi K3,Qwen 3.8 Max- принимают на себя роль лидеров, выдающих задачи, либо проверяющих результатClaude Sonnet 5,GPT-5.6-terra high,Gemini 3.6 Flash High,GLM-5.2- принимают на себя роль работяг, выполняющих основную работуClaude Haiku 4.5,GPT-5.6-luna,Qwen 3.7 Plus,Gemini 3.6 Flash- принимают на себя роль исследователей, либо исполнителей четкой последовательности действий с большим количеством выходных результатов необходимых обработать (например, анализ лог файлов)
Модели можно настраивать под ваши нужды и кошелек (тот же GLM-5.2 может отлично подойти на роль планировщика, а вместо него может встать deepseek-v4-flash-0731). Данный подход существенно снизит расходы при исполнении больших задач и решит проблемы переполнение контекста, о которых поговорим в самом конце, затрагивая ограничения Агентов.
А более подробное описание мульти-агентского конвейера заслуживает отдельной статьи и видео!
Example workspace setup
Давайте теперь рассмотрим пример какого-то рабочего окружения и типовых сценариев использования.
Наш сценарий будет состоять из некоторого проекта, который собирается в разных окружениях (в том числе в удаленном окружении), запускать и тестировать его надо с выполнением определенных условий, а коммиты должны поддерживать определенный формат.
В данном случае, нам не потребуются специализированные агенты и отдельные MCP сервера, только несколько Навыков.
What we will use
Для данного теста воспользуемся Pi, но можете использовать то, что ближе вашей душе.
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
Настраиваем провайдера по нашему вкусу, я буду пользоваться Ollama Cloud. Помимо этого нужны будут следующие расширения для агента:
pi install npm:pi-web-access
pi install npm:pi-ollama-cloud
pi install npm:@juicesharp/rpiv-ask-user-question
С данными расширениями для Pi у LLM появится возможность искать решение в интернете, задавать нам вопросы в виде диалогового окна.
Coding Agent configuration
Проект будет собираться под 3 целевые платформы: Linux x86 и два BitBake таргета под ARM64.
Мы начинаем с пустого Rust проекта без какой-либо конфигурации, поэтому начать стоит с запроса на генерацию файла AGENTS.md. Напишем небольшой промпт:
## Goal

Generation of introductory AGENTS.md file for this project.

## Requirements

- it should contain basic instructions about build & test on host system.
- it should contain list of build targets for this project:
  - BitBake <SYSTEM> build
  - BitBake WebOS OSE build
  - Host system build
- BitBake targets should contain placeholders for skills which would be generated in a next steps
- it should provide basic information for any newcoming agent about project high level structure - where it should go, if some task should be done
- base information about code style and tests structure
- lastly, keep all output strictly concise, factual, and minimal
Проект небольшой, поэтому необходимости в поддержке дополнительной документации нет. Агент вполне справиться с изучением самостоятельно на каждой сессии
npx cloc src/
      21 text files.
      21 unique files.
       0 files ignored.

github.com/AlDanial/cloc v 2.06  T=0.01 s (1719.9 files/s, 158311.2 lines/s)
-------------------------------------------------------------------------------
Language                     files          blank        comment           code
-------------------------------------------------------------------------------
Rust                            21            237             30           1666
-------------------------------------------------------------------------------
SUM:                            21            237             30           1666
-------------------------------------------------------------------------------
После того, как мы получили какой-то AGENTS.md файл - перечитываем его, исправляем ошибки, если есть.
Теперь нужно перейти к генерации Навыков - простого пути здесь нет, описываем задачу агенту и просим выполнить, постоянно задавая нам вопросы - как получили результат, требуем зафиксировать на "бумаге".
Skills generation for an AI Agent
Стоит отметить, что здесь мы не будем говорить о проактивном создании Навыков агентами или, иначе говоря, о саморазвивающихся агентах.
Мы рассмотрим основной механизм для создания своих Навыков. Механизмов здесь несколько, мы рассмотрим хороший и рабочий.
Начнём с рабочего - обращайтесь, как с ребенком, постарайтесь заставить модель выполнить вашу задачу, с ошибками и неточностями. Как закончили попросите сформировать Навык из полученного опыта. Скорее всего, этого будет достаточно для повторения той же задачи с намного меньшими усилиями в следующий раз.
В хорошем варианте мы изначально понимаем, что работа предстоит повторяющаяся, поэтому имеет смысл заранее сказать LLM, что те шаги, которые мы сейчас будем проходить, необходимо зафиксировать в каком-то Навыке.
Для подобного рода задач отлично подходит создание нового Навыка, что-то на подобии представленного ниже (но это необязательно, можно вставить тело напрямую в ваш запрос)
---
name: skill-creation
description: use this skill when a user asks you to learn, figure out, or work out how to do something; do not use for plain task requests like "build this project"
---
# Skill Creation Protocol

## Goal
Guide the user to define and generate a portable, zero-hardcoding Pi skill before executing work.

## Skill Output Structure
Skills must strictly follow this structure. No hardcoded IPs, hosts, absolute paths, or credentials — these are resolved in step 0 of the generated skill, never carried over from this session.
However, anything related to a goal, relative paths, target names should be left as-is.

\```md
---
name: <skill_name>
description: <trigger_phrasings>
---
# Skill Name
## Step 0 — Resolve environment
Ask or derive host, paths, and credential names before proceeding.
## Skill Heading One
...
\```

## Workflow Rules
1. **Interview & Scope:** Ask 1–2 direct questions to clarify the skill goal, inputs, and operational parameters.
2. **Drafting:** Output the draft inside a single unified `SKILL.md` code block after each user input. Do not alter the core goal without explicit confirmation.
3. **Execution Check:** Test or validate steps one at a time via system tools. Query the user if an unresolvable blocker occurs.
4. **Finalization:** Save to `.pi/skills/<skill_name>/SKILL.md` only after final approval.Do not save final results before execution check.
Если мы создали Навык, то в самой сессии нам достаточно определить только цель!
> I want you to learn new skill on how to compile this project on remote build server & deploy artifacts on target
Проходим собеседование и следим за работой агента, корректируем в каких-то деталях, чем меньше модель, тем больше проблем возникнет на пути и больше конкретных деталей нужно будет передать модели, стоит быть терпеливым и настойчивым!
Для проверки работы Навыка создаем новую сессию и просим выполнить задачу уже без описания:
> Compile this project for <TARGET> & deploy artifacts on remote <REMOTE>
Debugging with AI Agent
Отладка, как и все остальное - это точно такое же повторяемое действие, надо подключаться к удаленному устройству, знать как устанавливать и запускать проект, а также, чем пользоваться для отладки.
Для всего этого нужны опять Навыки, однако их количество зависит от размера модели, если у вас большая, хорошая модель (хотя бы GPT-5.6-luna), то потребуется только один навык с кратким описанием последовательности действий в вашем конкретном случае, которую модель, потенциально, сможет изучить сама, при первом запуске.
I want you to learn a new skill on how to debug this project on local system.
Если у вас есть определенная специфика сборки, с которой, по вашему мнению, агент из коробки не справится - обязательно добавляйте эту информацию в ваш запрос, сэкономите себе время и нервы!
Чем меньше модель, тем более детально нужно описывать различные аспекты задачи.
Хорошая новость заключается в том, что для одного проекта вам достаточно это сделать единожды! Далее, через Навыки, модель сможет повторять этот результат раз за разом 🎉
Adding new feature in code
Здесь всё зависит от языка программирования и размера кодовой базы.
Если кодовая база большая, много целей сборки и деталей, то обязательно воспользуйтесь openwiki , либо языковым сервером (например, clangd для C++) . Прогулки по большой кодовой базе требуют весомых затрат контекста.
В случае, если вы столкнулись с проблемами, решения два:
- Декомпозиция большой задачи на маленькие.
- Подключение дополнительных инструментов к агенту
В общем случае, желаемое вами поведение закладывается в самом запросе, обязательно указывайте, что генерируемый код должен быть проверен, написаны и запущены юнит-тесты и проверена функциональность в конечном приложение.
Полезным Навыком здесь может послужить TDD (Test Driven Development).
Limitations of AI Agents
Напоследок хотелось бы поверхностно затронуть тему ограничений.
Dumb-Area. Context management
Dumb Zone / Dumb Area - область контекстного окна (часто начинающаяся уже на 40-60\% от заявленного объёма или около 32K-128K токенов в зависимости от модели), где из-за рассеивания внимания (Attention Degradation) модель начинает забывать древние инструкции, повторять исправленные ошибки и галлюцинировать.
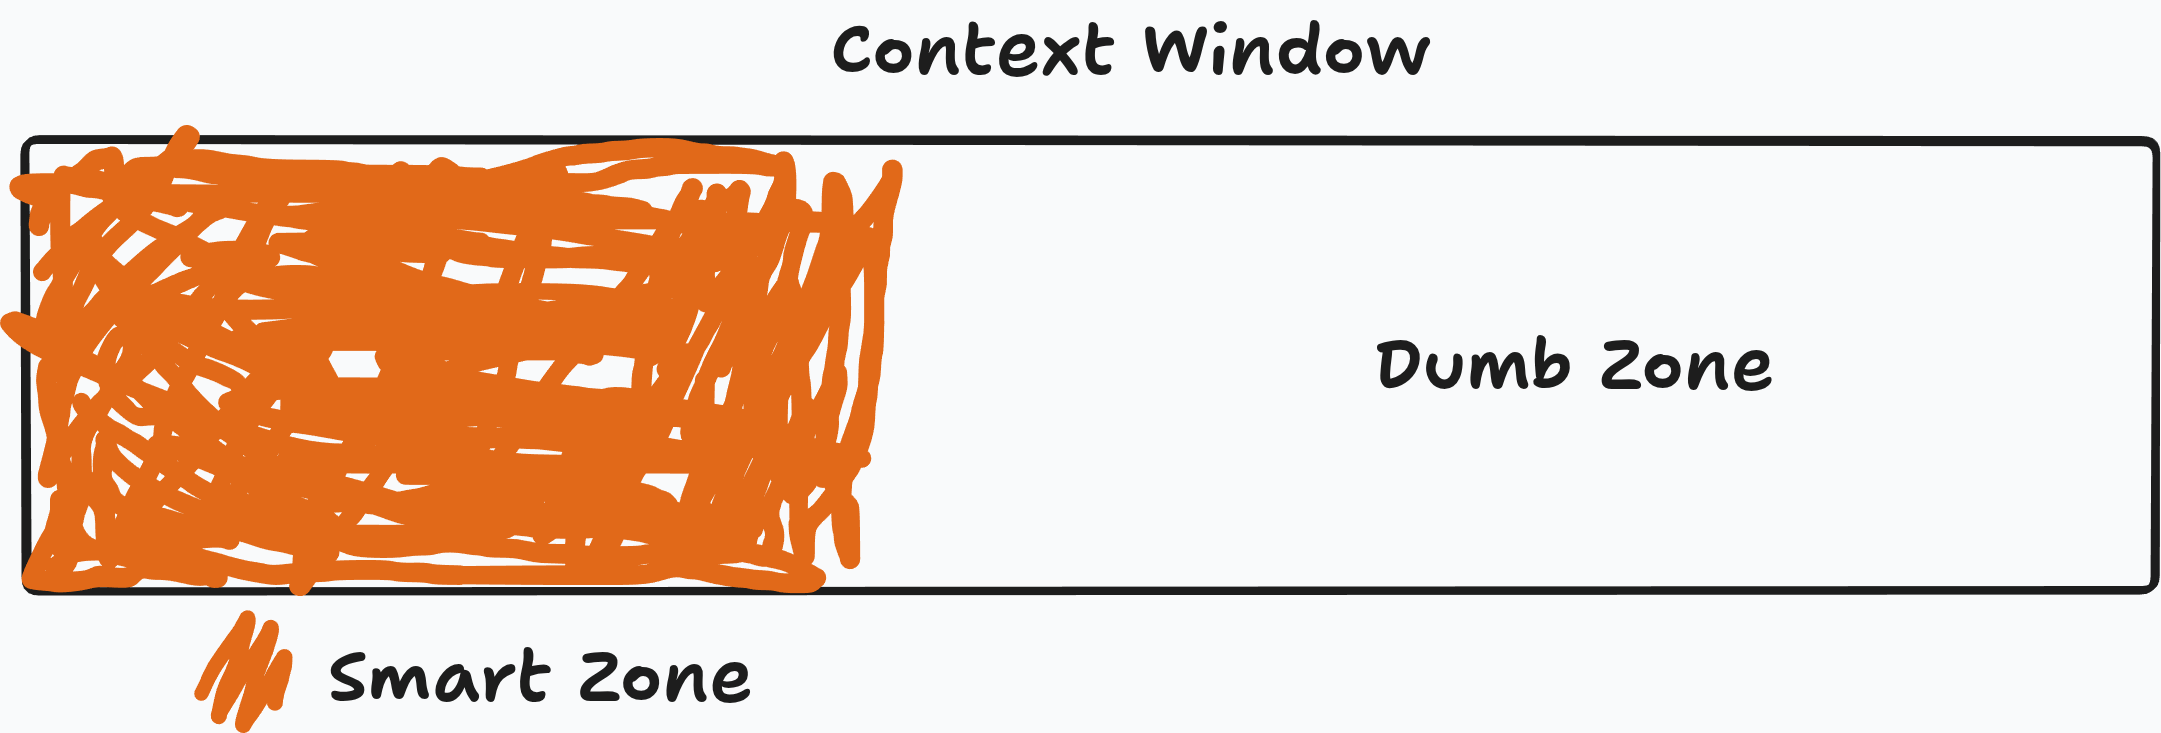
Основной вывод из данной ситуации заключается в том, что нельзя бездумно использовать AGENTS.md, подключать миллионы MCP серверов с огромным количеством инструкций, это неизбежно приведет к ситуации, где модель "убегает" из Smart Zone после первого запроса, что делает работу малоэффективной. По этой же причине принято сжимать контекст после каждого шага.
Attention curve. Lost-In-The-Middle
"Зона глупости" является следствием данного эффекта
Lost-In-The-Middle — это зафиксированный эмпирический феномен деградации внимания LLM. Кривая внимания модели при работе с длинным текстом имеет U-образную форму (U-shaped Attention Curve): модель отлично помнит информацию в самом начале и в самом конце контекстного окна, но критически теряет ("забывает") факты, расположенные в середине.
Чтобы обойти Lost-In-The-Middle, в современных агентах применяются следующие подходы:
- System Prompt Pinning: Принудительный проброс критических ограничений и инструкций в самый конец истории (прямо перед новым запросом), чтобы важные детали находились в пике внимания.
- Изоляция в Субагентах: Разбиение задач на небольшие изолированные сессии, чтобы размер контекста каждого агента не разрастался до объемов, где проявляется прогиб U-кривой.
Conclusion
Разумеется, ИИ Агенты - не являются волшебной пулей, как вы могли увидеть. С большой силой автоматизации приходит и большая ответственность в контроле над результатом и каждым шагом. Многие вещи нейросети делают все ещё плохо, для многих задач необходимо тонко настраивать окружение.
В рамках данной статьи ни разу не поднималась тема методологий разработки с агентами, тем более Harness Engineering и harness, в целом, потому что это все задачи следующих частей и семинаров, тем не менее, надеюсь, что вы нашли эту статью полезной!
 mattpocock
Рекомендуемый словарь
P.S. да, заголовок был клик-бейтным :)